• За нас
  • Пишете ни!
събота, 10 октомври, 2026
Няма резултати
Виж всички резултати
Epoch Times Bulgaria
  • България
  • Европа
  • САЩ
  • Русия
  • Китай
  • Свят
  • Култура
  • Наука
  • Дух и съзнание
  • Начин на живот
Epoch Times Bulgaria
Няма резултати
Виж всички резултати
Начало Наука и технологии

Проучване установи, че съдържание на китайски държавни медии е включено в данните за обучение на изкуствен интелект

отМайкъл Джуан
26 май , 2026
Проучване установи, че съдържание на китайски държавни медии е вградено в данните за обучение на ИИ

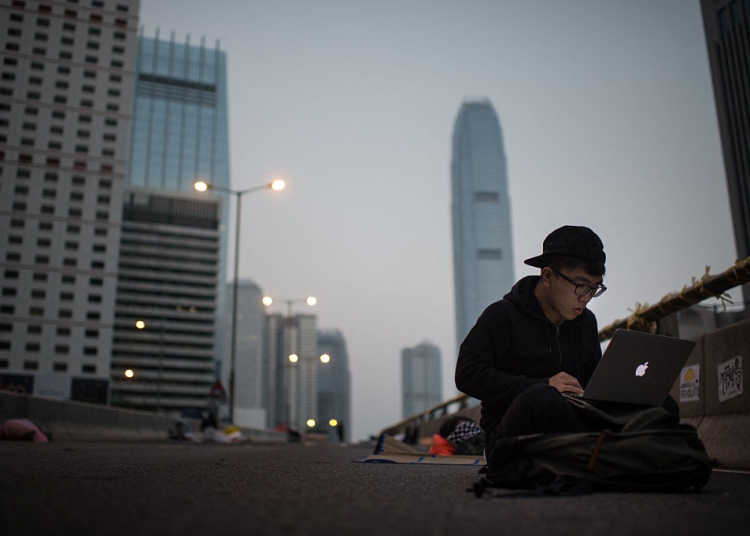
Про-демократичен протестиращ използва лаптоп, седнал на блокиран път в квартал Адмиралтейство в Хонконг в ранните часове на 8 октомври 2014 г. Ед Джоунс/AFP чрез Getty Images

Проучване на Nature установи, че китайски държавни медии са широко включени в наборите от данни за обучение на ИИ и може да влияят върху начина, по който моделите отговарят на чувствителни политически въпроси

Ново изследване показва, че съдържанието от китайски държавни медии е дълбоко вградено в наборите от данни, използвани за обучение на водещи системи за изкуствен интелект (ИИ). Това може да влияе върху начина, по който някои модели отговарят на политически чувствителни въпроси.

Проучването, публикувано в научното списание Nature на 13 май, установи, че в наборите от данни за обучение на големи езикови модели се съдържат значителни количества материали от китайски държавни издания, сред които Синхуа и „Жънмин жибао“.

Според изследването, когато получават запитвания на китайски език по теми, свързани с политическата система на Китай или чувствителни вътрешни въпроси, няколко водещи ИИ системи – включително ChatGPT, Claude и Gemini – по-често генерират отговори, съответстващи на официалната позиция на китайския режим. Отговорите на същите въпроси на английски език, според проучването, нерядко се различават по тон или разстановка на акцентите.

Изследователите подчертаха, че не са открили доказателства за хакване или пряка манипулация на ИИ системи. Вместо това те твърдят, че ефектът вероятно се дължи на структурата на самите данни, използвани за обучение.

Китайските държавни медии публикуват огромни количества свободно достъпно, широко разпространено и унифицирано форматирано съдържание. То се събира по-лесно от уеб роботите, използвани в процесите за обучение на ИИ. За разлика от тях, независимите новинарски организации по-често работят зад платена стена, прилагат ограничения за авторски права или блокират автоматизираното събиране на данни – което ограничава присъствието им в обучителните набори.

Тази асиметрия, според проучването, може неволно да осигури по-голямо присъствие на държавно ориентираните наративи в системите за машинно обучение, разчитащи на данни от отворения интернет.

Как обучителните данни могат да оформят поведението на модела

Изследователи, анализирали голям набор от данни с отворен код на китайски език, известен като CulturaX, установиха, че той съдържа около 189 милиона документа. В рамките на този набор съдържанието от китайски държавни медии е представено в мащаб, далеч надхвърлящ обема на китайскоезичната Уикипедия.

Анализът установи също, че в политически натоварени контексти – включително препратки към Китайската комунистическа партия или китайското ръководство – съдържанието на държавните медии представлява значителен дял от релевантния материал в набора от данни.

Когато изследователите тестваха множество ИИ модели със сравними запитвания на китайски и английски език, те отчетоха забележими разлики. В някои случаи отговорите на китайски по-често включваха официална терминология или отразяваха наративи, широко използвани в политическия дискурс на Пекин. Английските отговори, за разлика от тях, като цяло бяха по-неутрални или по-разнообразни по формулировка.

За разлика от традиционните медийни канали – като телевизия или вестници – ИИ системите генерират синтезирани отговори, които могат да изглеждат неутрални, дори когато отразяват модели, вградени в обучителните данни.

Проучването разширява анализа си до десетки страни и предполага наличието на по-широка закономерност: в среди с по-ниска свобода на печата резултатите от ИИ системи, обучени на местноезикови данни, по-често отразяват държавно ориентирани формулировки.

Сун Чен участва в изготвянето на този материал. 
Споделете тази статия
Tags: Изкуствен интелектКитайски режим и ККП

Вашият коментар Отказ

Вашият имейл адрес няма да бъде публикуван. Задължителните полета са отбелязани с *

Последвайте ни във Фейсбук

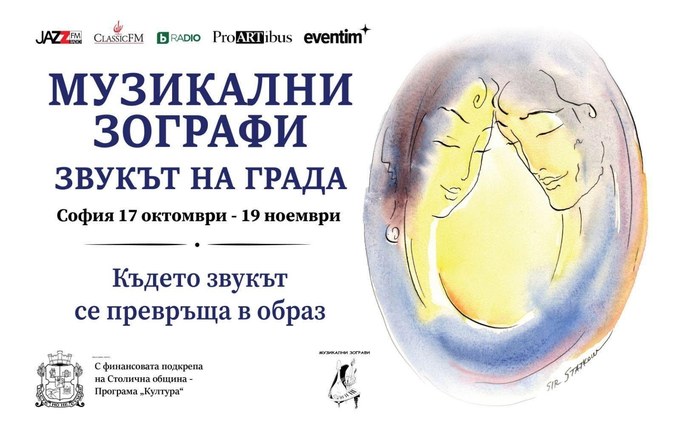
Фестивал „Музикални зографи – Звукът на града“, София, 17 октомври – 19 ноември 2026

НАЙ-ТЪРСЕНИ ДНЕС

id6099947 entree potatoes 20261005 1080x720 1

Хрупкави картофи за закуска с ароматни подправки

0
0
Плодове хинап (снимка: Ева Иванова)

Хинап (китайска фурма) – 10 ползи за здравето

0
0
6e1cf44c 90e2 4460 a3ad 681198af4e93

Ученици се срещат с японски музиканти и балетни артисти в Старозагорската опера

0
0
Снимка: Министерство на енергетиката

България подкрепя обща енергийна позиция на шест държави пред ЕС

0
0
b8ced6ef 0006 4483 b6bf d49f6724d77a

Фредерик Шопен е първият поляк, който влиза в списъка с музикални класици

0
0
Снимка: Министерство на околната среда и водите

Европейски държави обсъдиха в България бъдещето на буковите гори от списъка на ЮНЕСКО

0
0
Софийски маратон, 2025 г.

Над 12 000 бегачи от 70 държави превръщат София в столица на маратона

0
0

Свързани Публикации

Учени спечелиха Нобеловата награда за химия за открития за огледалните молекули, довели до създаването на много лекарства

Учени спечелиха Нобеловата награда за химия за открития за огледалните молекули, довели до създаването на много лекарства

0
0
Ще обезцени ли изкуственият интелект реалния свят?

Ще обезцени ли изкуственият интелект реалния свят?

0
0
id6099514 ap26278372667862 av 1

САЩ предупредиха за риск от чума в Русия

0
0
id6100430 aptopix nobel physics 26279590600442

Нобелова награда за физика за откривател на космически неутрино

0
0
id6066100 openai gptlive

OpenAI призна пробив в Medicare

0
0
Руски институт за чумата отдавна работи с Китай

Руски институт за чумата отдавна работи с Китай

0
0
Снимка: Министерство на иновациите

Нов конкурс на ЕКА открива възможности за българските космически технологии

0
0
id6096156 entree soup 20260928 1080x720 1

Когато температурите паднат, е време за купичка супа с броколи и чедър

0
0
Снимка: Министерство на здавеопазването

Детското затлъстяване във фокуса на здравната политика на България до 2030 г.

0
0
Учени спечелиха Нобеловата награда за химия за открития за огледалните молекули, довели до създаването на много лекарства

Учени спечелиха Нобеловата награда за химия за открития за огледалните молекули, довели до създаването на много лекарства

0
0
Следваща публикация
Ситуацията с хантавируса е стабилна, заяви директорът на СЗО

Ситуацията с хантавируса е стабилна, заяви шефът на СЗО

Epoch Times лого
Facebook X-twitter Goodreads-g Youtube Instagram Telegram
  • Последни новини
  • Направете дарение

35 страни, 21 езика

  • English
  • 中文
  • Español
  • עברית
  • 日本語
  • 한국어
  • Bahasa Indonesia
  • Français
  • Deutsch
  • Italiano
  • Português
  • Svenska
  • Nederlands
  • Русский
  • Українська
  • Română
  • Česky
  • Slovenščina
  • Polski
  • Türkçe
  • فارسی
  • За нас
  • Авторски права
  • Условия за ползване
  • Пишете ни!
  • Поверителност на информацията
  • България
  • Свят
  • Китай
    • COVID-19 и Ваксинация
  • Култура и изкуство
  • Наука и технологии
  • Начин на живот
  • Мнения
  • За нас
  • Авторски права
  • Условия за ползване
  • Пишете ни!
  • Поверителност на информацията
Copyright © 2024 Epochtimes.bg | Всички права запазени Epochtimes.bg не носи отговорност за съдържанието на външни сайтове | Divinitum – дигитален маркетинг партньор.
Няма резултати
Виж всички резултати
  • България
  • Европа
  • САЩ
  • Русия
  • Китай
  • Свят
  • Култура
  • Наука
  • Дух и съзнание
  • Начин на живот

© 2019 Epoch Times България.

Epoch Times Bulgaria