Новинарски организации, автори и музиканти твърдят, че технологични компании са откраднали труда им, за да обучават своите модели с изкуствен интелект
Разработчиците на изкуствен интелект са изправени пред десетки съдебни искове, заведени от създатели на съдържание, които твърдят, че компаниите са откраднали труда им, за да извличат печалба и да създават продукти, които в крайна сметка могат да заменят цели индустрии.
Исковете, заведени от медии, автори, фотографи и текстописци, посочват, че компаниите са използвали техните произведения за обучение и разработване на инструменти с изкуствен интелект, без да им плащат възнаграждение, като същевременно бързат да направят творческия им труд ненужен.
Професорът по право в университета „Санта Клара“ Едуард Лий поддържа онлайн регистър, който показва, че близо 100 такива дела са на етап събиране на доказателства или преди този етап, докато страните по делата подготвят доказателства за съда.
Други са насочени към постановяване на решение по съкратена процедура, при която съдията ще реши спора без пълен съдебен процес.
Докато бързо разрастващата се индустрия на изкуствения интелект поражда все по-голяма тревога за нейния потенциал да унищожи човечеството, тези съдебни дела открояват друг аспект на безпокойството – че технологията представлява и заплаха от екзистенциален мащаб за традиционните индустрии за създаване на съдържание.
В по-широк план те подчертават напрежението между ползите от разработването на нови технологии и възможното унищожаване на класическото, движено от хората събиране на информация и творческо производство.
„Порочният кръг“
Новинарските компании и други страни твърдят, че компаниите за изкуствен интелект вредят на дейността им, като използват без възнаграждение техния висококачествен труд, създаден с време, усилия и средства.
„Ответниците се стремят да се възползват безплатно от огромните инвестиции на The Times в журналистиката, като използват работата му, за да създават заместващи продукти без разрешение или заплащане“, се казва в иск, заведен от The New York Times и над десетина новинарски издания.
Нашата стратегия за съдържание за изкуствен интелект е задействала „порочен кръг“, който едновременно ще навреди на представянето на нашите модели и на цялата мрежа.
Брент Хект, директор по приложни науки в Microsoft, цитиран в съдебни документи
Наскоро разкрити документи по това дело – заведено срещу OpenAI и Microsoft – изглежда показват, че компаниите са били наясно, че методите им могат да бъдат проблематични.
„Милиони хора по света скоро ще смятат, че големите модели, които ‚поглъщат с прахосмукачка‘ целия им труд, представляват поразителна кражба в безпрецедентен мащаб“, заяви директорът по приложни науки на Microsoft Брент Хект, според съдебен документ.
„Нашата стратегия за съдържание за изкуствен интелект е задействала ‚порочен кръг‘, който едновременно ще навреди на представянето на нашите модели и на цялата мрежа“, заяви Хект в друг вътрешен документ, цитиран в съдебните материали.
От 2023 г. OpenAI работи за осигуряване на лицензи от новинарски издания, чието съдържание се използва за обучение на моделите ѝ, като започна с The Associated Press през юли същата година. Последваха споразумения с News Corporation, The Washington Post, Politico и други.
Ответниците се стремят да се възползват безплатно от огромните инвестиции на The Times в журналистиката, като използват работата му, за да създават заместващи продукти без разрешение или заплащане.
Искът за нарушаване на авторски права New York Times срещу Microsoft и OpenAI
Исковете са заведени от компании, които са отхвърлили тези лицензионни споразумения.
Meta сключи подобни договори, но също беше съдена от отделни автори, с които не е постигала споразумения. Google си партнира със социалната мрежа Reddit, за да обучава модела си, но едва след съдебен иск от отделни ищци, според които компанията извличала лични данни на потребители от целия интернет.
Anthropic не е обявявала лицензионни споразумения и вместо това се позовава на доктрината за добросъвестна употреба в своя защита пред съда.
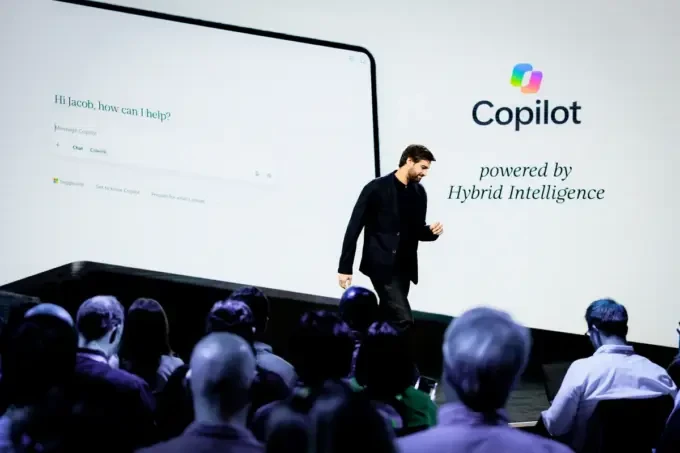
Джейкъб Андреу, изпълнителен вицепрезидент на Microsoft Copilot, говори на събитие на Windows в Сан Франциско на 7 октомври 2026 г. Heather Diehl/Getty Images
Добросъвестна употреба?
За да обучат моделите си с изкуствен интелект да отговарят правилно на запитванията на потребителите, компаниите първо трябва да ги захранят с огромно количество информация. Тази информация трябва да дойде отнякъде и голяма част от нея е защитена с авторско право.
Компаниите обаче твърдят, че събирането на защитени с авторско право текстове за обучение на модели с изкуствен интелект е защитено от доктрината за добросъвестна употреба съгласно раздел 107 от Закона за авторското право.
Добросъвестната употреба допуска изключения от авторското право според обстоятелствата. Сред примерите са използването на защитени материали за научни изследвания, преподаване или критика.
Дали изключението е приложимо зависи от начина, по който се използва защитеният с авторско право материал, каза пред The Epoch Times Кевин Фрейзър, директор по иновации и право в областта на изкуствения интелект в Тексаския университет в Остин.
„Обосновката за това се свежда предимно до първия фактор, който съдилищата преценяват, когато анализират дали нещо попада в обхвата на доктрината за добросъвестна употреба – а именно този неясен, но изключително важен термин ‚трансформативна употреба‘“, заяви той.
Случаите, при които компании за изкуствен интелект „извличат“ текстове от интернет, книги или други източници и използват данните за обучение на своите модели, е по-вероятно да попаднат в обхвата на добросъвестната употреба, посочи Фрейзър.
„Полученият резултат е изключително сложен, нюансиран и усъвършенстван модел с изкуствен интелект, който коренно се различава от оригиналното произведение, използвано за обучението на самия модел, и поради тази причина мнозина го смятат за трансформативен.“
През 2025 г. Meta спечели дело, заведено от 13 автори, които заявиха, че компанията е използвала техни произведения за обучението на своя модел с изкуствен интелект „Llama“.
Съдията по делото постанови, че използването на книгите им за обучение на модела е „силно трансформативно“ и че ищците не са доказали продуктът на Meta да е оказал влияние върху пазарната стойност на техните произведения.
През 2025 г. съдия постанови, че използването от Meta на книги за обучение на нейния модел с изкуствен интелект Llama е „силно трансформативно“ и не е повлияло върху пазарната стойност на произведенията на авторите.
Министерството на правосъдието на САЩ се включи по въпроса за добросъвестната употреба в началото на септември, като заяви, че изкуственият интелект е важен за националната сигурност и че правителството има „суверенен интерес“ от насърчаването на иновациите в тази област.
Правителството призовава съдилищата да постановят, че доктрината за добросъвестна употреба позволява на компаниите за изкуствен интелект да извличат информация от защитени с авторско право материали. Това е необходимо, за да се стимулира конкуренцията от по-малки фирми, посочи Министерството на правосъдието, тъй като „само най-големите технологични компании биха могли да разполагат с капитала, необходим за плащането на лицензионни такси“.
Входящи данни срещу резултати
Случаите, при които моделът с изкуствен интелект генерира нов материал, е по-малко вероятно да издържат правната проверка, каза Фрейзър.
„Ако поискате от модел да напише нова глава от ‚Хари Потър‘ или, да речем, нова глава от много известна книга, в този случай това не изглежда толкова трансформативно, нали?“, каза той.
Според Фрейзър съдилищата ще преценяват и други фактори, като въздействието върху потенциалната пазарна стойност на защитеното произведение, дали използваният материал е фактически или творчески и каква част от произведението е използвал моделът с изкуствен интелект.
Според един съдебен документ ръководителят на ChatGPT в OpenAI е написал, че продуктите с изкуствен интелект представляват „екзистенциална заплаха“ за издателите, „до голяма степен са заместващи“ и „ще стават все по-заместващи, колкото повече се усъвършенстват“.
Подобни изявления „унищожават“ твърденията на компаниите за изкуствен интелект за добросъвестна употреба, заявиха адвокатите на новинарските агенции.
Направо от днешните заглавия
The New York Times не е единственото новинарско издание, което оспорва правата на компаниите за изкуствен интелект и претенциите им за добросъвестна употреба.
News Corporation, компанията майка на New York Post и The Wall Street Journal, съди стартъп за изкуствен интелект, който се хвали, че позволява на потребителите да „прескочат линковете“, като им предоставя информация, без да се налага да посещават медийни сайтове.
Компанията Perplexity AI заяви, че е „първата в света ‚търсачка за отговори‘ – лесен за използване инструмент, който позволява на обществото да получава актуални, кратки и фактологични отговори на въпроси“.
За тази цел тя има достъп до защитени с авторско право материали, но също предоставя връзки към тях – ако клиентът желае.
Но ако клиентите прескачат линковете, това намалява печалбите на новинарските източници, според иска.
„Това поведение на Perplexity, независимо къде се извършва, има за цел и/или предвидимо действително лишава [ищците] от клиенти, приходи от реклама и приходи от абонаменти“, се казва в жалбата им.
Perplexity отговори, че резултатите от нейния изкуствен интелект не са предварително изготвени, а са непредвидими и се основават на запитванията на клиентите. „Фактът, че след неразкрит брой опити служител на ищците твърди, че е успял да подтикне Perplexity да даде отговори, които ищците определят като нарушаващи права, не казва нищо за това дали друг потребител в Ню Йорк или на друго място някога е търсил или получил същите или подобни отговори“, се казва в съдебния документ на компанията.
Делото продължава.
Getty Images също заведе дело във Великобритания, като твърди, че стартъпът Stability AI е използвал огромната ѝ колекция от снимки, за да обучи своя модел Stable Diffusion. Моделът е можел да генерира изкривени версии на изображения от библиотеката на Getty и да добавя фалшив воден знак на Getty.
Stability AI заяви, че не носи отговорност, ако трета страна използва продукта ѝ, за да добави водния знак.
Според съдия Джоана Смит от Висшия съд на Великобритания „няма доказателства нито един потребител във Великобритания да е генерирал чрез по-късния модел на Stability нито Getty Images, нито водните знаци“, макар че това може да се е случвало при по-ранни версии с отворен код.
В крайна сметка съдът постанови, че няма компетентност по отношение на нарушенията, тъй като няма доказателства те да са извършени на територията на Великобритания.
Унищожаване на книги
През юли федерален съдия одобри споразумение на стойност 1,5 млрд. долара между Anthropic и група автори ищци, които твърдят, че компанията е използвала пиратски копия на техни произведения – незаконно изтеглени от интернет – за обучението на своя модел Claude.
Първоначално компанията беше заплашена от плащания в размер на десетки милиарди долари. Делото обхващаше над 480 000 книги, като за всяка от тях можеше да бъде наложена санкция до 150 000 долара съгласно законодателството на САЩ за авторското право.
По това дело съдията заяви, че използването на книгите за обучение на модели с изкуствен интелект е трансформативна добросъвестна употреба. Нарушението е било използването на пиратските копия.
Случаят повдигна още повече въпроси, когато стана ясно, че Anthropic е купувала физически копия на книги, но ги е унищожавала, след като е качвала текстовете им. Говорител на Anthropic заяви, че компанията не използва и не унищожава копия на редки книги.
Друго подобно дело срещу производителя на чипове Nvidia продължава. Макар че петима автори заведоха иск през 2024 г., случаят все още е на етап събиране на доказателства.
В съдебен документ Nvidia се позова на добросъвестната употреба и отрече да е нарушавала авторски права, но призна, че е използвала „набор от данни на трета страна, наречен ‚The Pile‘“, за да обучи модела си Nemo Megatron.
Авторите по делото твърдят, че The Pile – текстов файл от 800 гигабайта, съставен от изследователска компания за обучение на модели с изкуствен интелект – е съдържал друг набор от данни, Books3, в който са имало копия на техни произведения.
Според жалбата им Books3 първоначално е бил хостван от стартъпа за изкуствен интелект Hugging Face, но е бил премахнат през 2023 г. заради „сигнал за нарушение на авторски права“.
Текстове на песни
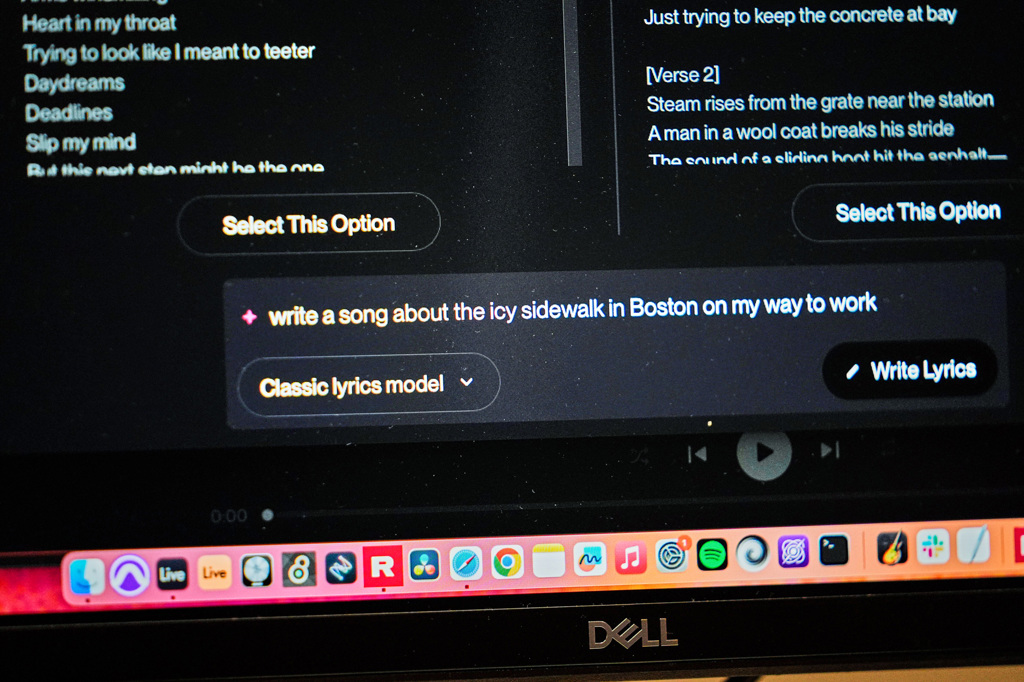
Група музикални издатели също съди Anthropic, като твърди, че потребителите получават незаконен достъп до текстове на песни чрез модела ѝ Claude. Макар да има уебсайтове, в които потребителите могат да търсят текстове на песни, тези сайтове трябва да плащат лицензионна такса.
Ищците, водени от Concord Music Group, заявиха също, че Claude генерира нови песни въз основа на акордовите прогресии и почти идентични текстове на защитени с авторско право произведения, дори когато потребителите не са поискали изрично това.
„Например, когато следовател на издателите поиска да бъде написана ‚песен за смъртта на Бъди Холи‘, Claude генерира дословно копие на текста на ‚American Pie‘“, се посочва в жалбата.
Междувременно Anthropic заяви, че Claude има функции за „защита на авторските права“ и че компанията не може да носи отговорност, когато потребител намери начин да ги заобиколи.
„Когато една система ‚създава копието единствено в отговор на команда на потребителя‘, нейният оператор не извършва волево действие“, заяви Anthropic в съдебен документ. „Потребителят го извършва.“